Computer Use / GUI Agent:后训练与自进化评测
问题
面向网页与桌面端的业务流程自动化,GUI Agent 需要在真实界面上完成检索、填写、跨页面操作与结果 提交等多步任务,对操作正确性、异常恢复和长流程稳定性要求很高,基础模型难以直接达到可用水平。 与此同时,任务类型、页面状态与操作路径持续变化,人工逐题验收成本高,难以及时发现能力边界、覆盖 薄弱场景。项目因此分两条线:把模型训好(后训练),以及把模型测准(自动评测与题库自进化)。
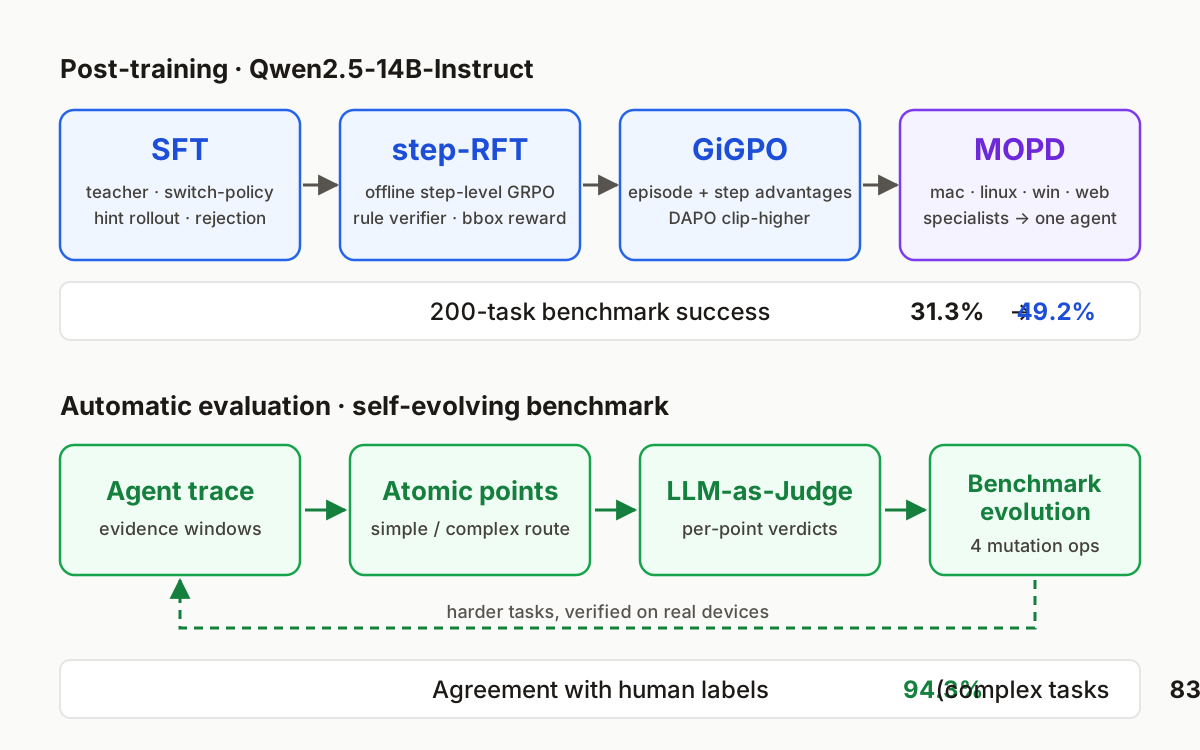
一、后训练:SFT → 离线 step-RFT → 在线 GiGPO → 多平台 MOPD
多源 SFT 轨迹与配比。 构建四类轨迹生产链路:教师轨迹、switch-policy 纠错轨迹、hint 引导 rollout(后处理改写为 CoT)与拒绝采样,并通过配比实验确定数据组合;仅纯教师轨迹 SFT 就带来 9.7% 的提升。
switch-policy 纠错轨迹。 弱策略先执行错误动作,强策略接管并完成纠正,补足”失败—恢复”场景。 对已被纠正的错误 step 屏蔽 loss,避免模型模仿错误动作:
其中
离线 step-level GRPO(step-RFT)。 固定轨迹上下文
规则 verifier 按格式、动作类型、参数三阶段打分;click 动作的参数奖励在 golden bbox
以纠错轨迹占比较高的 SFT checkpoint 初始化,step-RFT 再带来 4% 增益。
可验证的细粒度奖励。 以任务 progress 为主项,叠加 side-effect、false-complete、 post-success-abort 与 overdue 惩罚(示意):
并对 AnswerSheet 错答做伪完成校正,抑制模型通过虚假”已完成”状态获取奖励。
在线 GiGPO 两级优势 + DAPO clip-higher。 GiGPO 在两个层级上做组内归一化。episode 级
按同一任务的
step 级把不同轨迹中处于同一状态
策略更新采用 DAPO 的非对称裁剪(clip-higher,
相比轨迹级 GRPO,两级优势实现了更细粒度的 credit assignment。
多平台 MOPD:把平台专家融合成一个通用 Agent。 不同操作系统的界面元素、快捷键与操作习惯差异
很大,把所有平台混在一起做 RL 容易相互干扰。因此在 GiGPO 之后,先按 macOS、Linux、Windows、
Web 四个场景分别做 GiGPO,得到各自的平台专家
实际优化采用带训练—推理重要性采样的代理损失,
token 级优势由平台专家的对数概率比给出,并叠加结果奖励的优势——本项目中直接复用上一阶段的
可验证奖励与 GiGPO 优势
这样学生既吸收各平台专家的操作习惯,又保留任务完成度这一全局目标,最终以单一模型覆盖四个平台。
二、自动评测与 Benchmark 自进化
构建「trace 自动评测 → 题库自进化」闭环:将任务拆解为原子评分点(point),以 LLM-as-Judge 自动完成逐条判定,并按任务类型路由到简单 / 复杂两类评测链路。
- 窗口化 point 判定与复杂任务核验。 按时间顺序把 trace 切成证据窗口,批量判定各窗口 中的评分点并分组聚合得分。信息检索类任务只抽取智能体实际可观测的页面事实,识别”答案正确 但证据来源虚构”的情形;循环类任务逐窗抽取操作实体、跨步骤去重并核验执行次数,降低漏计与 重复计数风险。
- Benchmark 自进化。 设计四类变异算子,沿解题链把种子任务改造成更难的新任务;基于真实 设备执行 trace 构建能力约束,保证新任务功能上可实现。候选任务经真实设备可达性验证与 独立复核后写入题库,形成可持续扩展的评测机制。
结果
| 指标 | 结果 |
|---|---|
| 200 条专家解法 benchmark 成功率 | 31.3% → 49.2%(SFT → step-RFT → GiGPO) |
| 纯教师轨迹 SFT 增益 | +9.7% |
| step-RFT 增益 | +4% |
| LLM-as-Judge 与人工标注一致率 | 94.3%(复杂任务 83.2%) |
公式参考:GRPO 见 DeepSeekMath(Shao et al., 2024),GiGPO 见 Feng et al., 2025,MOPD 见 MiMo-V2-Flash 技术报告(Xiaomi, 2026),DAPO 见 Yu et al., 2025;标注”示意”的公式为本项目设计的结构化表达,具体系数从略。