@unpublished{fu2026rose,
  title={ROSE: A Shared Cross-Embodiment Facial-Motion Latent Space for Humanoid Robot Expression},
  author={Fu, Yongji and Cao, Man and Zhou, Yi and Lin, Fei and Hansen, Mark F. and Cao, Guanqun},
  note={Submitted to IEEE International Conference on Robotics and Automation (ICRA)},
  year={2026}
}
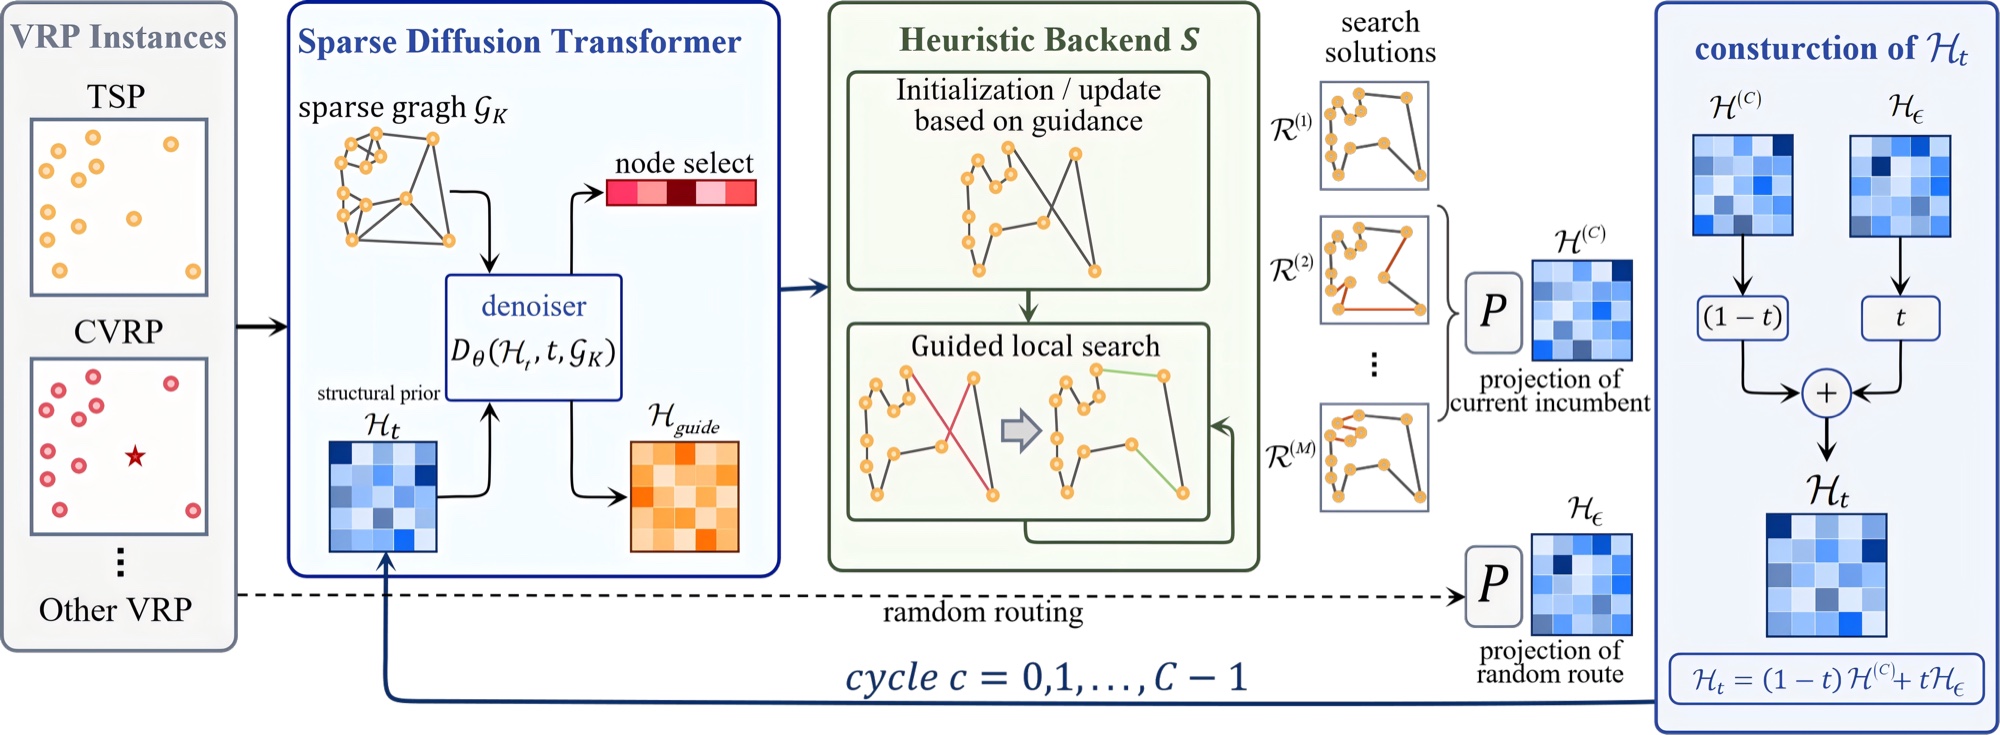
为解决这一问题,我们提出 LSSL(Learning to Search, Searching to Learn),
一个面向大规模 VRP 的学习—搜索闭环框架。LSSL 首先在稀疏候选图上预测搜索友好的结构先验,随后搜索在这些先验的引导下
迭代精化当前解。更关键的是,搜索并不在一轮精化后就退出系统:推理阶段,搜索返回的结构状态被反馈给模型,用于下一轮预测;
训练阶段,多条高质量搜索解被组织成行级软目标,用于模型更新。由此形成”学习告诉搜索去哪里探索,搜索告诉模型哪些
结构值得学习”的闭环。实验表明,LSSL 在多个大规模 VRP 基准上同时取得良好的可扩展性、效率和解质量。
@inproceedings{fu2026lssl,
  title={Learning to Search, Searching to Learn: A Closed-Loop Framework for Large-Scale Vehicle Routing},
  author={Fu, Yongji and Zhou, Yi and Jin, Gaojie and Cao, Guanqun},
  booktitle={The Fortieth Annual Conference on Neural Information Processing Systems},
  year={2026}
}
@unpublished{fu2025touchbridge,
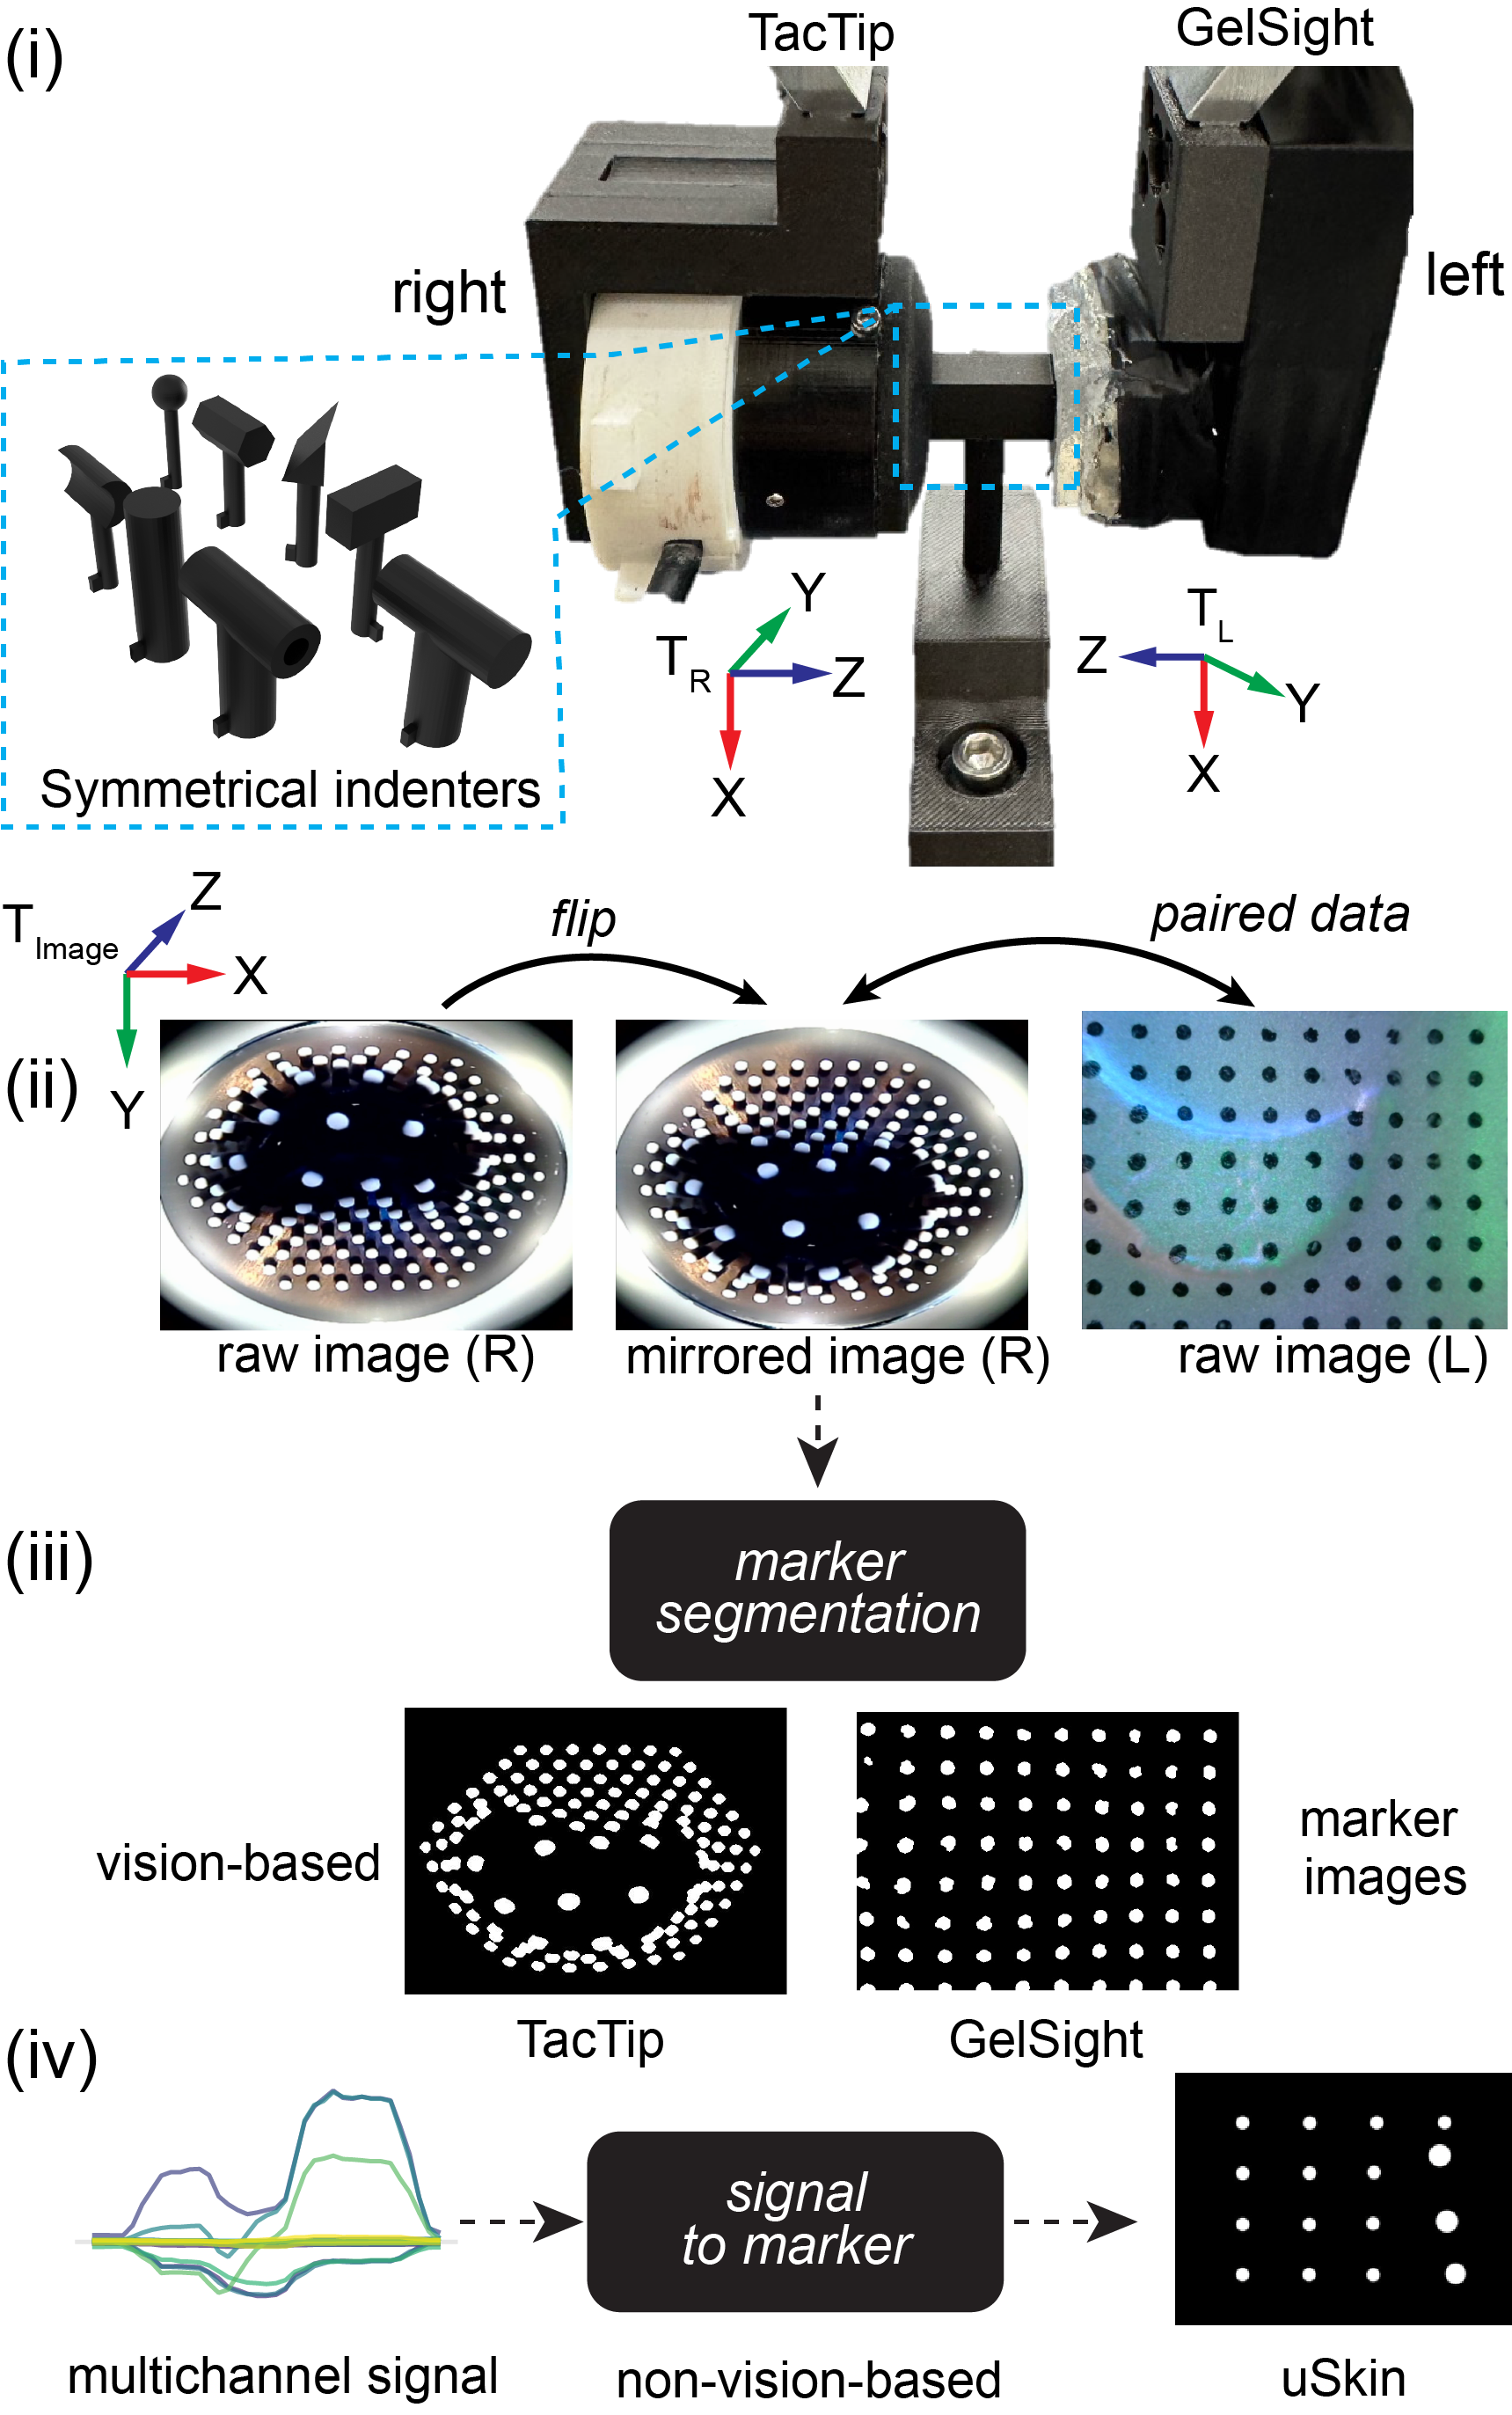
  title={TouchBridge: Multi-Bridge Alignment and Reversible Canonical Tactile Space for Cross-Sensor Robotic Manipulation},
  author={Fu, Yongji and others},
  note={Manuscript in preparation; target venue: IEEE International Conference on Robotics and Automation (ICRA) 2026},
  year={2025}
}
@unpublished{cao2025touchsteer,
  title={TouchSteer: Grounding Natural Language in Tactile Perception via Steering Vectors},
  author={Cao, Guanqun and Fu, Yongji and Zhou, Yi and Jin, Gaojie and Lu, Zhenyu and Luo, Shan},
  note={Manuscript in preparation; target venue: IEEE Transactions on Robot Learning (TRL)},
  year={2025}
}
S 盒(替换盒)是现代对称密码体制的核心组件,其非线性度、差分均匀性和不可预测性直接决定了密码算法的安全性。然而,
静态 S 盒一旦结构固定,就容易受到代数攻击与侧信道攻击。本文提出了一种动态 S 盒构造方案,结合二维混沌映射与
上的不可约多项式:混沌映射提供密钥敏感性与巨大参数空间,使不同密钥生成不同 S 盒;不可约多项式
则提供代数结构以约束最坏情况下的密码学指标。
消融实验在非线性度、严格雪崩准则(SAC)、比特独立准则(BIC)、差分/线性逼近概率以及生成效率等标准密码学指标上系统
评估所生成的 S 盒,结果均满足或优于密码学使用要求。
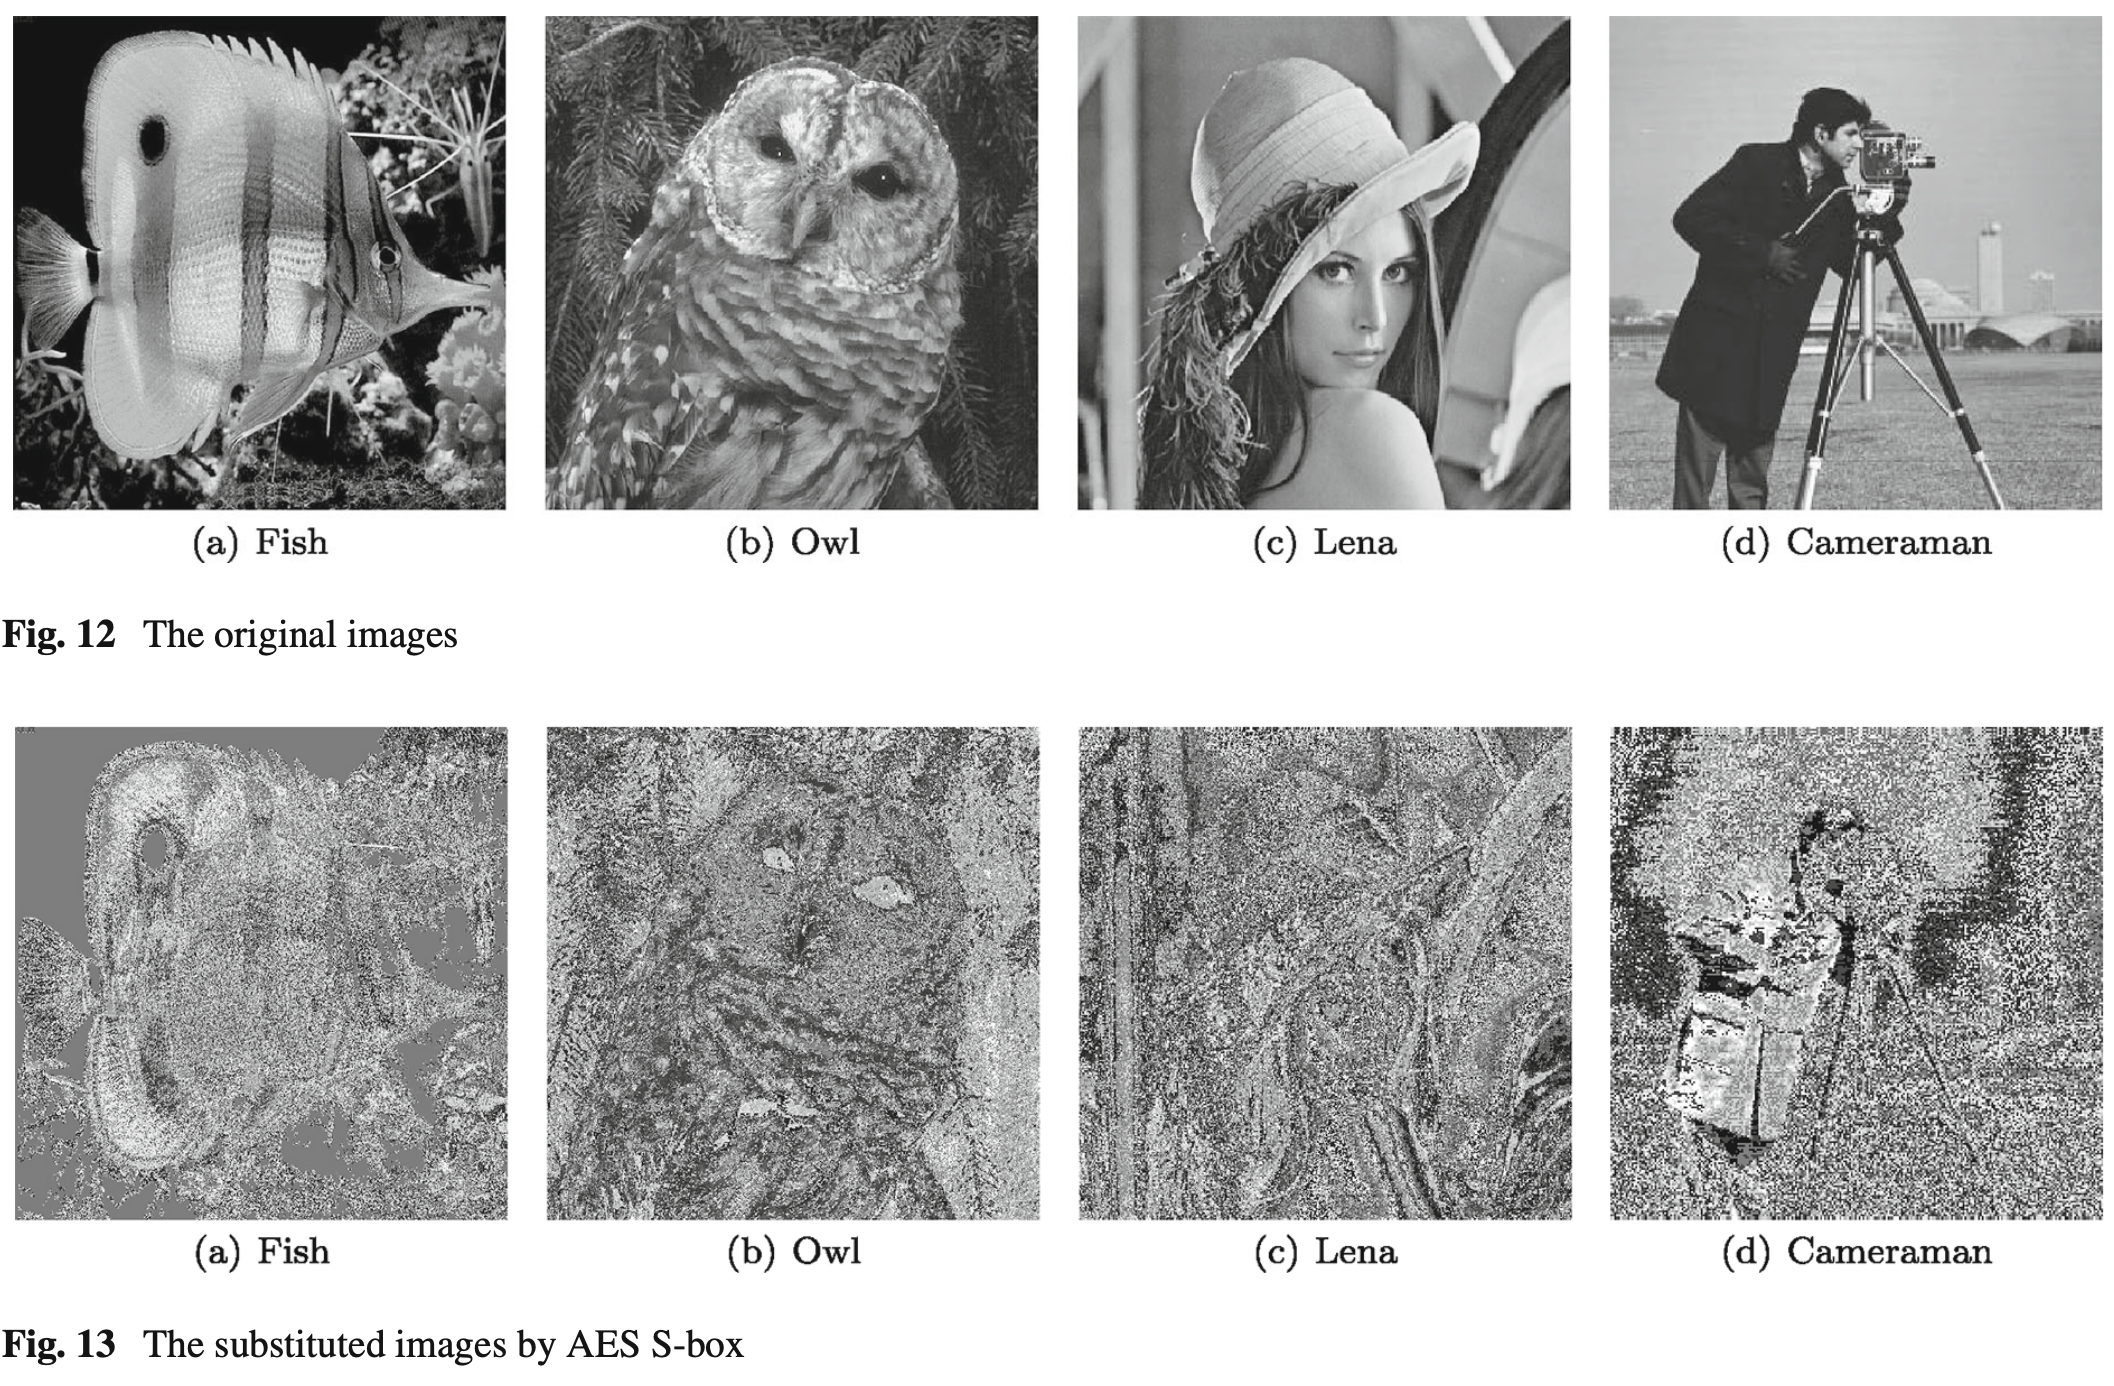
我们进一步将动态 S 盒集成到分组密码图像加密流程中,在标准测试图像上验证其加密效果:像素级扰乱与扩散效果显著,密文
直方图接近均匀分布,NPCR / UACI 分数高,能有效抵抗差分攻击、统计攻击与暴力破解。
@article{luo2024dynamic,
  title={Constructing Dynamic S-boxes Based on Chaos and Irreducible Polynomials for Image Encryption},
  author={Luo, Chenhong and Wang, Yong and Fu, Yongji and others},
  journal={Nonlinear Dynamics},
  year={2024},
  publisher={Springer}
}