Yongji Fu, Man Cao, Yi Zhou, Fei Lin, Mark F. Hansen, Guanqun Cao
ICRA 2027, 已投稿, 2026
摘要 · 引用
自然、连贯的全脸动态表情是让仿人机器人显得亲和可信的关键,但现有系统大多只能实现有限的唇部
运动或预设脚本表情。这一局限同时来自物理与算法两方面:紧凑的头部空间难以容纳密集且可独立
控制的执行器;而学习式系统通常先生成虚拟人视频、关键点或面部参数,再通过视觉重定向反推执行器
指令——这种”先渲染、再反解”的路径会引入额外延迟与伪影,也难以把生成的行为可靠地迁移到真实
机器人上。我们提出 ROSE(RObot facial expression through Shared motion Embeddings),
一个融合仿生硬件、跨具身运动表征学习与多模态运动生成的框架。硬件上,柔性腱鞘传动结构在
19.5 cm 高的仿生头部内集成 34 个执行器,将执行器布置与面部动作点解耦,在紧凑体积内实现
协调的全脸表情。算法上,ROSE-VAE 从真人、数字人与机器人观测中学习与身份无关的共享
面部运动潜空间;ROSE-Flow 以文本、音频或二者组合为条件,直接在该空间中生成运动轨迹,
生成器不以视频为输入;ROSE-Act 再把这些轨迹转换为满足约束的执行器指令。
@unpublished{fu2026rose,
  title={ROSE: A Shared Cross-Embodiment Facial-Motion Latent Space for Humanoid Robot Expression},
  author={Fu, Yongji and Cao, Man and Zhou, Yi and Lin, Fei and Hansen, Mark F. and Cao, Guanqun},
  note={Submitted to IEEE International Conference on Robotics and Automation (ICRA)},
  year={2026}
}
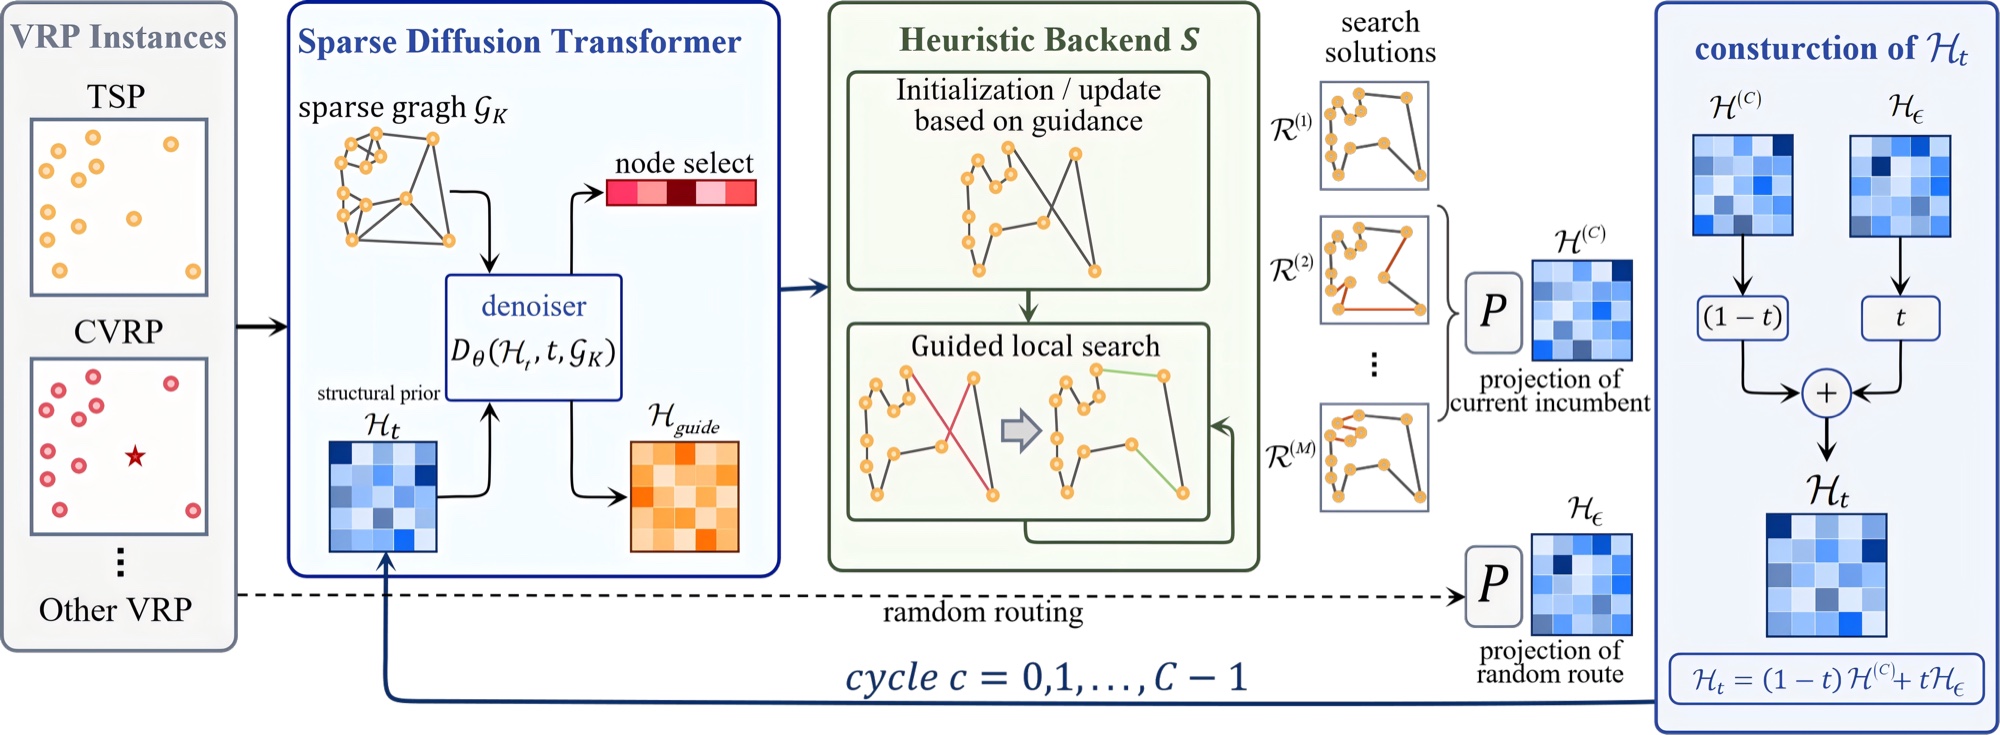
大规模车辆路径问题 (VRP) 面临两个长期难题。一方面,许多可扩展方法依赖于图划分、邻域候选限制或分阶段决策来控制计算量,
这削弱了模型对全局结构的建模能力;另一方面,虽然许多方法在测试阶段引入搜索以提升解质量,但搜索通常只作为模型预测之后
的一次性后处理——模型给出预测,搜索进行修复,两者之间缺乏持续反馈:改进后的结构状态很少被反馈回模型指导后续推理,
而高质量的搜索解也几乎不会进入后续的训练监督。
为解决这一问题,我们提出 LSSL(Learning to Search, Searching to Learn),
一个面向大规模 VRP 的学习—搜索闭环框架。LSSL 首先在稀疏候选图上预测搜索友好的结构先验,随后搜索在这些先验的引导下
迭代精化当前解。更关键的是,搜索并不在一轮精化后就退出系统:推理阶段,搜索返回的结构状态被反馈给模型,用于下一轮预测;
训练阶段,多条高质量搜索解被组织成行级软目标,用于模型更新。由此形成”学习告诉搜索去哪里探索,搜索告诉模型哪些
结构值得学习”的闭环。实验表明,LSSL 在多个大规模 VRP 基准上同时取得良好的可扩展性、效率和解质量。
@inproceedings{fu2026lssl,
  title={Learning to Search, Searching to Learn: A Closed-Loop Framework for Large-Scale Vehicle Routing},
  author={Fu, Yongji and Zhou, Yi and Jin, Gaojie and Cao, Guanqun},
  booktitle={The Fortieth Annual Conference on Neural Information Processing Systems},
  year={2026}
}
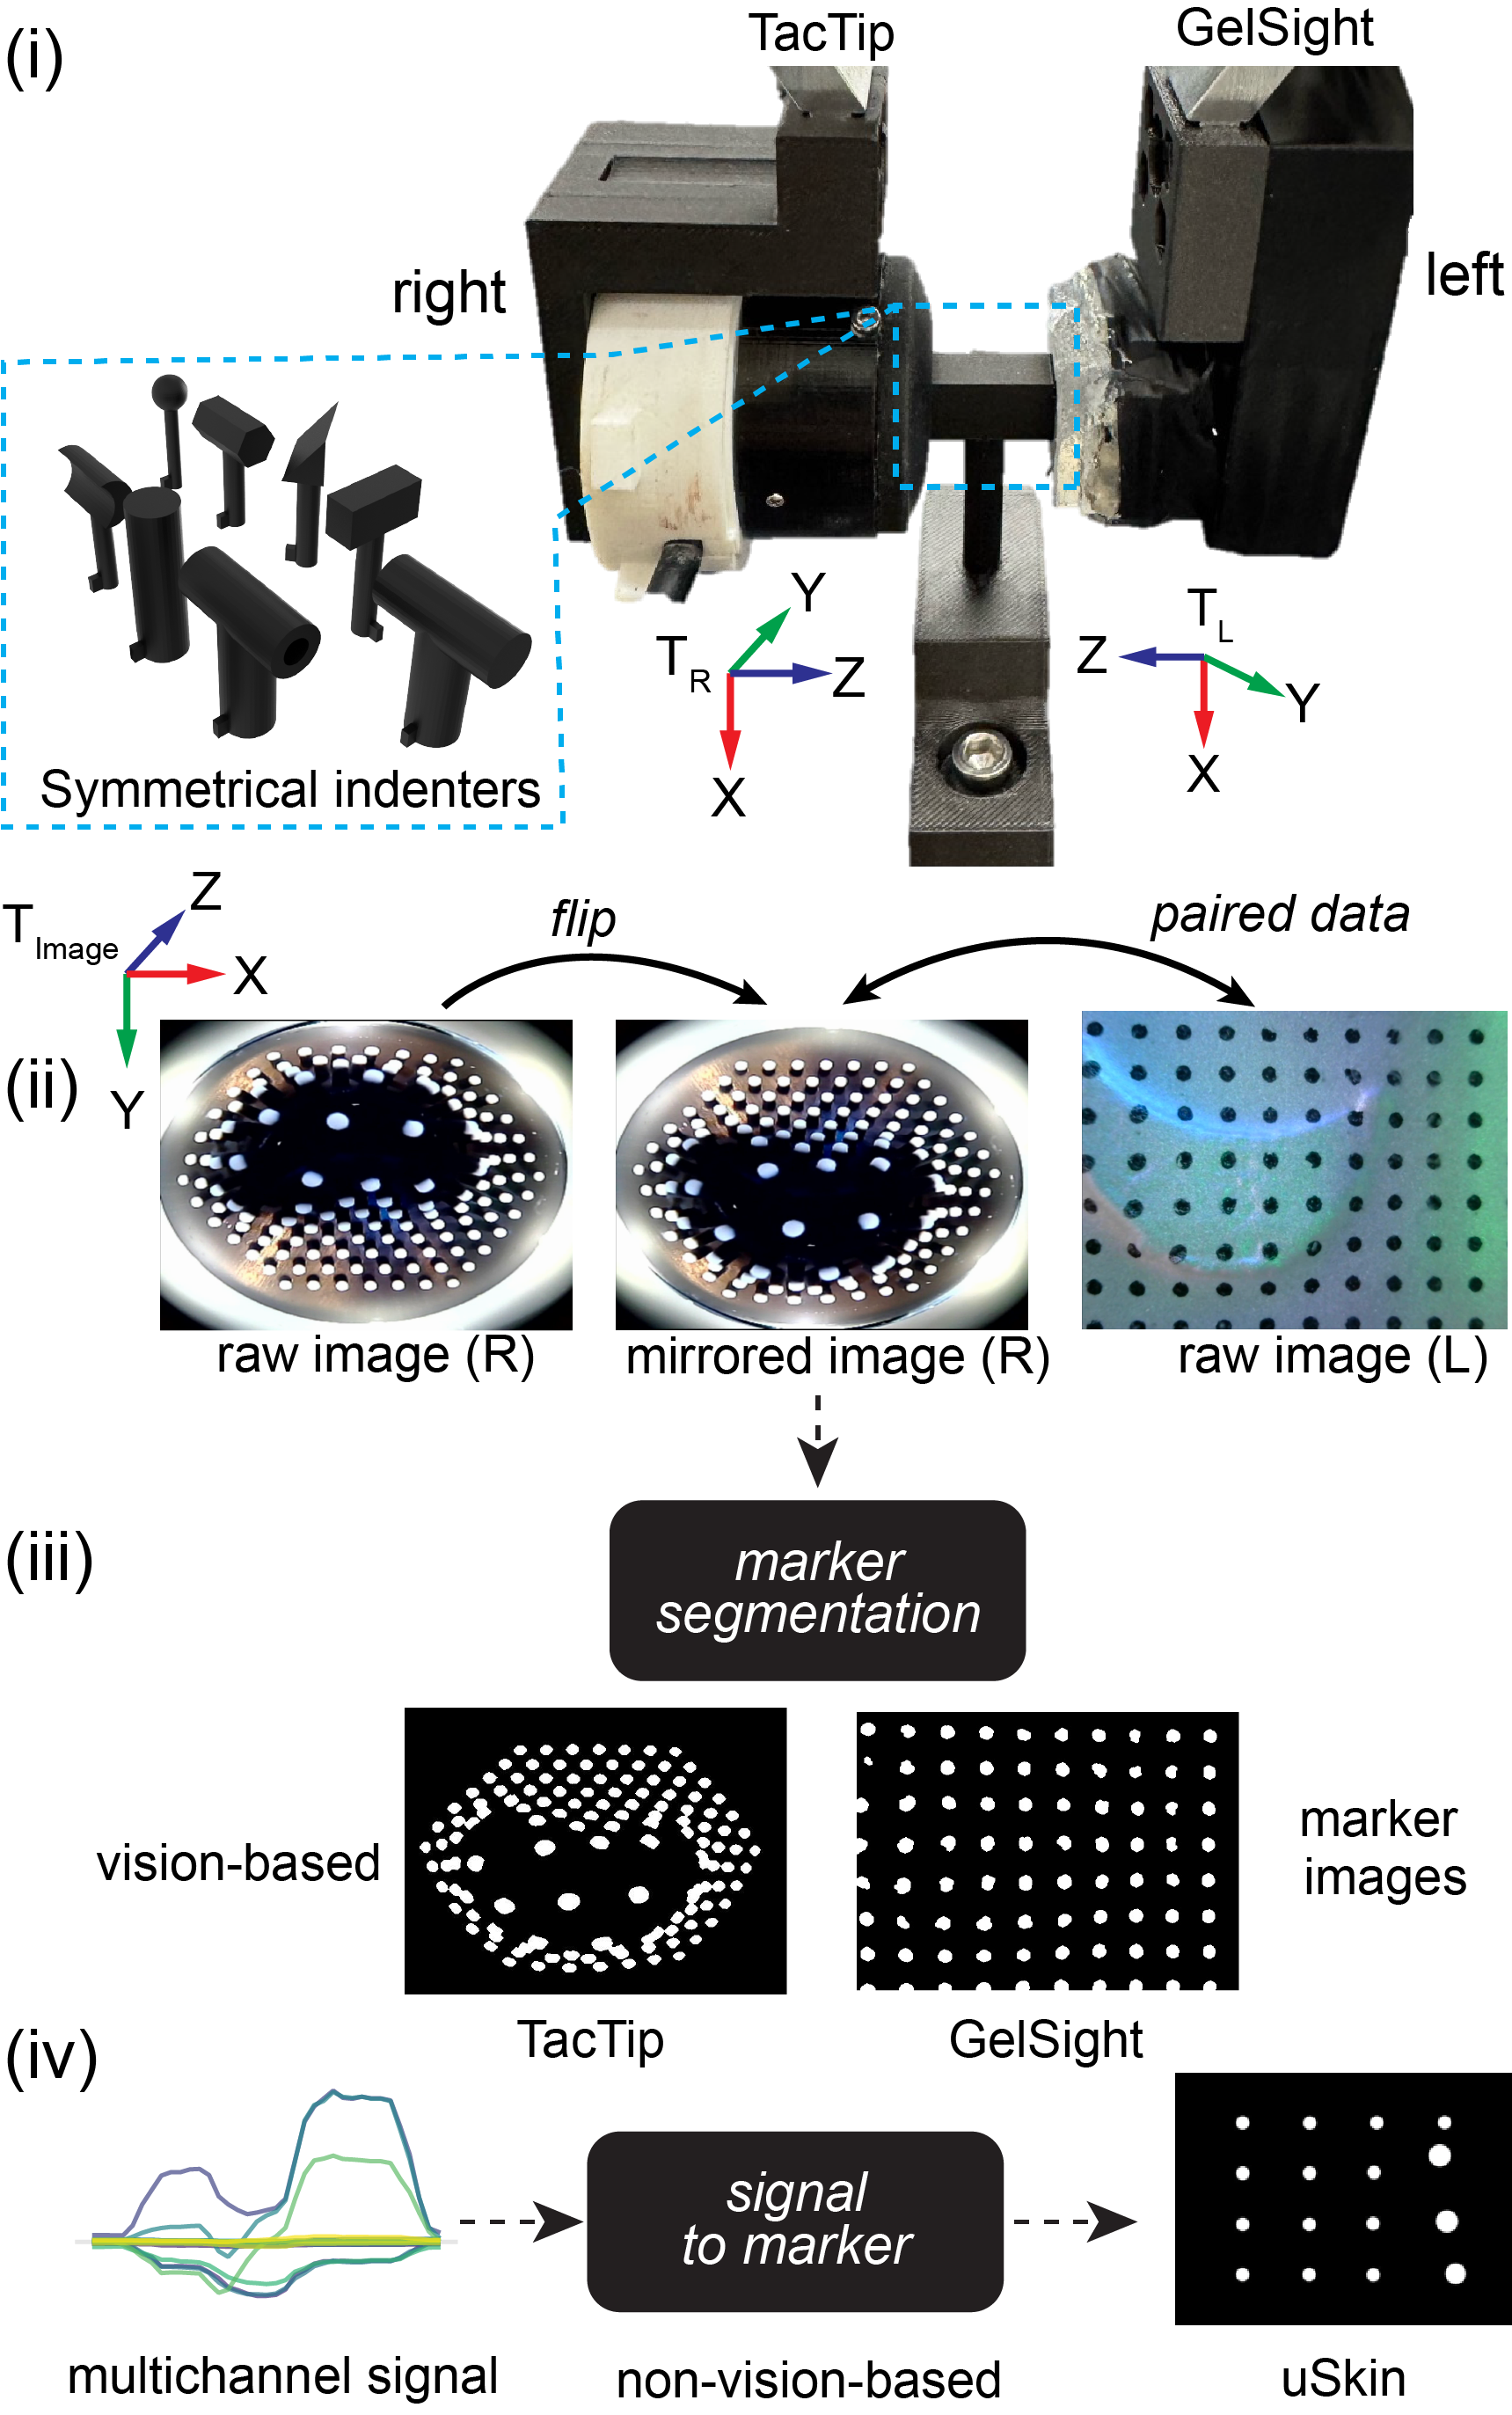
光学触觉传感器在几何形态、光照和读出方式上差异很大,因此在某个传感器上学到的表示或策略往往
无法迁移到另一个传感器,导致每换一个指尖就要重新采集数据、重新训练。TouchBridge 通过一个
可逆的规范触觉空间来解决这一问题:任意传感器都可以被映射进这一共享潜空间,并且关键在于还能
从中映射回来,使触觉信号能够在异构传感器之间相互转换,而不仅仅是被嵌入其中。
对齐通过**多桥接对齐(multi-bridge alignment)**学习——不使用单一的庞大编码器,而是让每个
传感器各自通过一个可逆的桥连接到规范空间,并对这些桥进行联合训练,使规范空间保持与传感器
无关,同时又能解码回各自的原生传感器域。这样,在某一传感器上训练的操作策略或表示就能在另一个
传感器上运行,几乎不需要新的触觉数据。
我们在跨传感器操作任务上进行评估,将触觉表示与基于接触的控制在不同传感器间迁移,结果表明可逆
的规范空间既保留了下游操作所需的接触信息,又实现了传感器到传感器的转换。
@unpublished{fu2025touchbridge,
  title={TouchBridge: Multi-Bridge Alignment and Reversible Canonical Tactile Space for Cross-Sensor Robotic Manipulation},
  author={Fu, Yongji and others},
  note={Manuscript in preparation; target venue: IEEE International Conference on Robotics and Automation (ICRA) 2026},
  year={2025}
}
Guanqun Cao, Yongji Fu, Yi Zhou, Gaojie Jin, Zhenyu Lu, Shan Luo
IEEE Transactions on Robot Learning, 审稿中, 2026
摘要 · 引用
触觉传感能通过接触直接获取物体的物理属性,然而大多数现有方法仅采用预定义属性标签来描述触觉数据,
语义灵活性受限。将触觉信号与自然语言对齐,可以得到更丰富的、概念级别的表示。
本文提出一种基于 Transformer 的触觉—语言框架,借助 Steering Vectors 将共享嵌入空间
组织为可操控的概念空间:这些向量把触觉属性编码为语义方向,使模型在有限监督下仍能对语义实施
显式控制。同一潜空间支持两个互补任务:给定描述期望触觉属性的自然语言查询时,机器人可在其触觉
经验中检索最相关的材料;而当机器人实际接触物体表面后,可生成对该表面触觉属性的自然语言描述。
实验结果表明,该框架能够从自由形式的自然语言中有效检索触觉表示,并生成具有感知依据的触觉描述,
从而更好地支持人—机器人交互。
@unpublished{cao2025touchsteer,
  title={TouchSteer: Grounding Natural Language in Tactile Perception via Steering Vectors},
  author={Cao, Guanqun and Fu, Yongji and Zhou, Yi and Jin, Gaojie and Lu, Zhenyu and Luo, Shan},
  note={Manuscript in preparation; target venue: IEEE Transactions on Robot Learning (TRL)},
  year={2025}
}